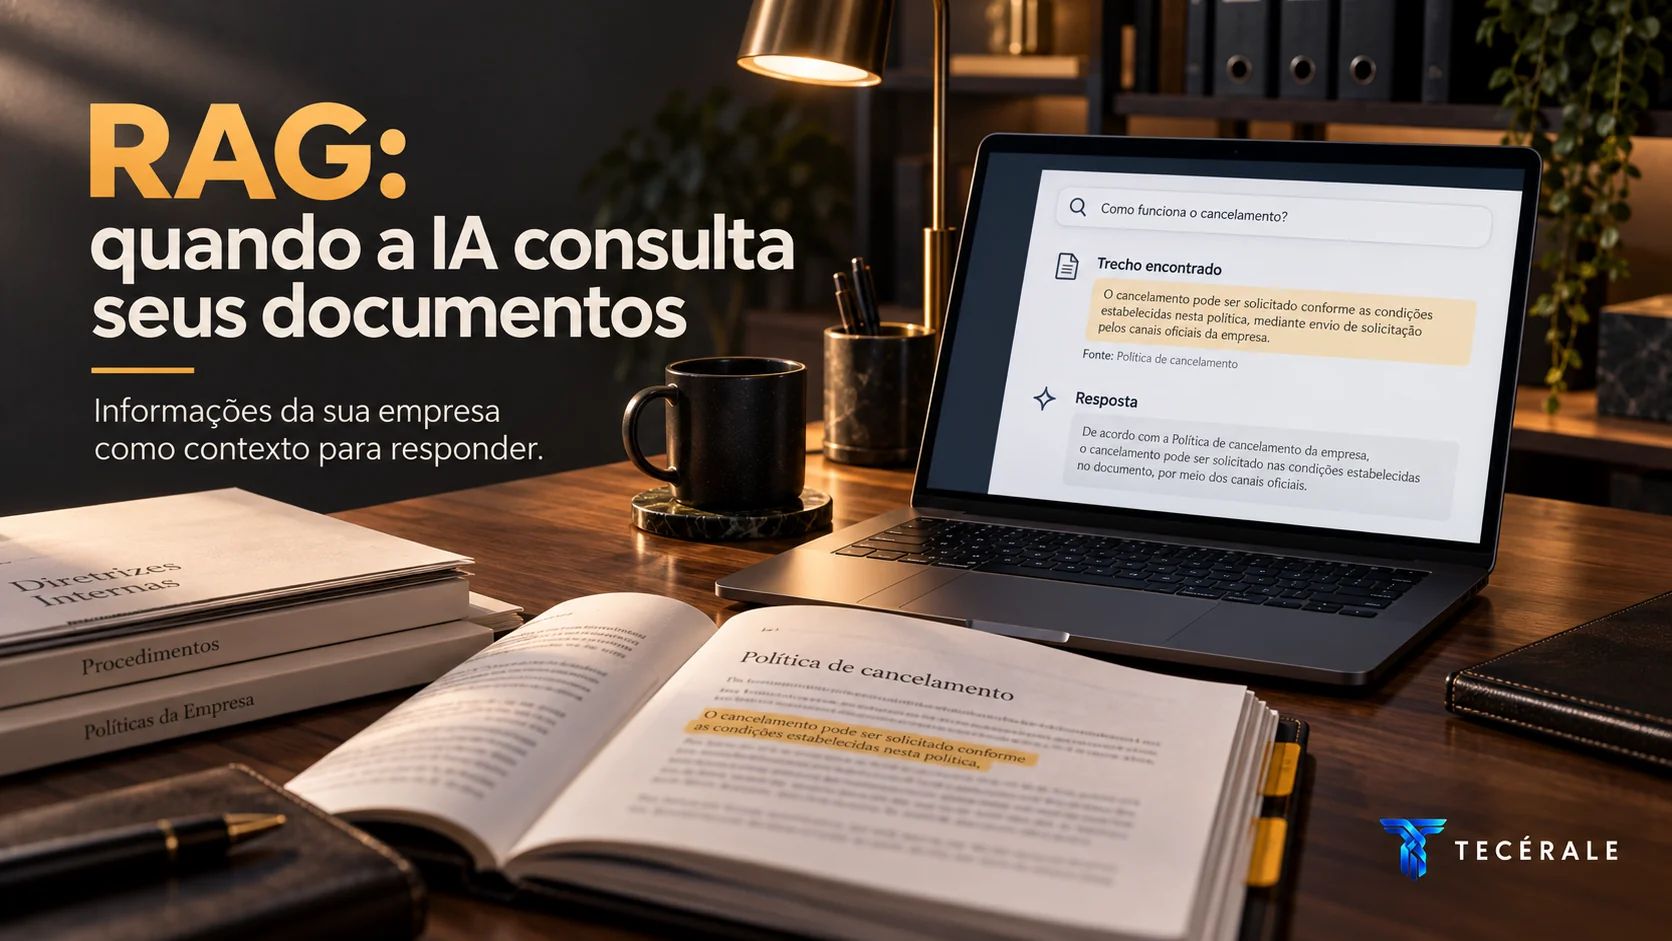
Imagine perguntar para uma IA:
“Qual é a política de cancelamento da minha empresa?”
Ela pode responder de duas maneiras muito diferentes.
Na primeira, tenta responder apenas com o conhecimento geral do modelo. Na segunda, procura a política real nos documentos da empresa, encontra o trecho relevante e usa essa informação para montar a resposta.
A segunda situação é a ideia central por trás do RAG.
O que é RAG?
RAG significa Retrieval-Augmented Generation, ou geração aumentada por recuperação.
O nome parece complicado. O conceito não é.
Em vez de pedir para o modelo responder apenas com o que já sabe, um sistema RAG faz uma busca em fontes externas — por exemplo, manuais, políticas, documentos internos ou uma base de conhecimento — e entrega ao modelo os trechos mais relevantes para aquela pergunta.
O modelo então gera a resposta usando esse contexto.
Em uma frase:
RAG é fazer a IA procurar a informação certa antes de responder.
Isso é especialmente útil quando o conhecimento necessário é privado, muito específico ou muda com frequência.
Como o RAG funciona na prática
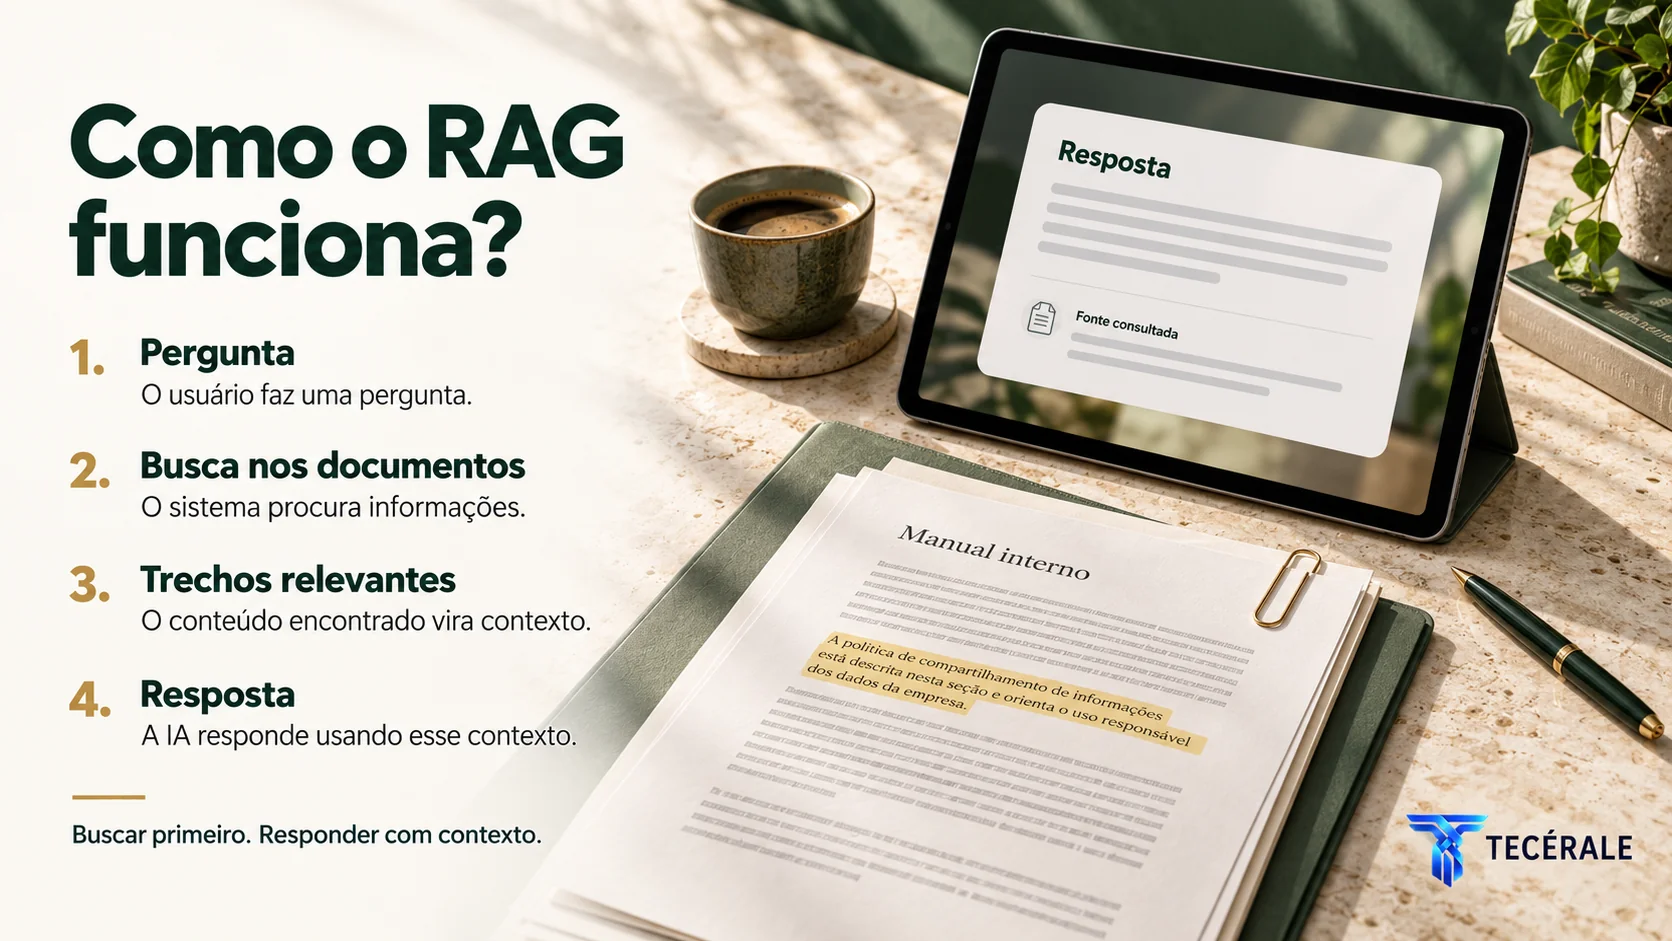
De forma simplificada, o fluxo possui quatro etapas:
- o usuário faz uma pergunta;
- o sistema procura informações relacionadas nas fontes disponíveis;
- os trechos considerados mais relevantes são enviados ao modelo;
- a IA gera uma resposta usando aquele contexto.
A Microsoft descreve o padrão de forma semelhante: recuperar conteúdo relevante, acrescentá-lo ao contexto e gerar uma resposta baseada nesse conteúdo.
Isso resolve um problema importante.
Uma empresa pode ter centenas ou milhares de páginas de documentação. Mandar tudo para a IA a cada pergunta seria caro, lento e, em muitos casos, pior para a qualidade da resposta.
O sistema de recuperação tenta encontrar somente o conteúdo que importa para aquela pergunta.
RAG não é treinar a IA com seus documentos
Essa é uma confusão muito comum.
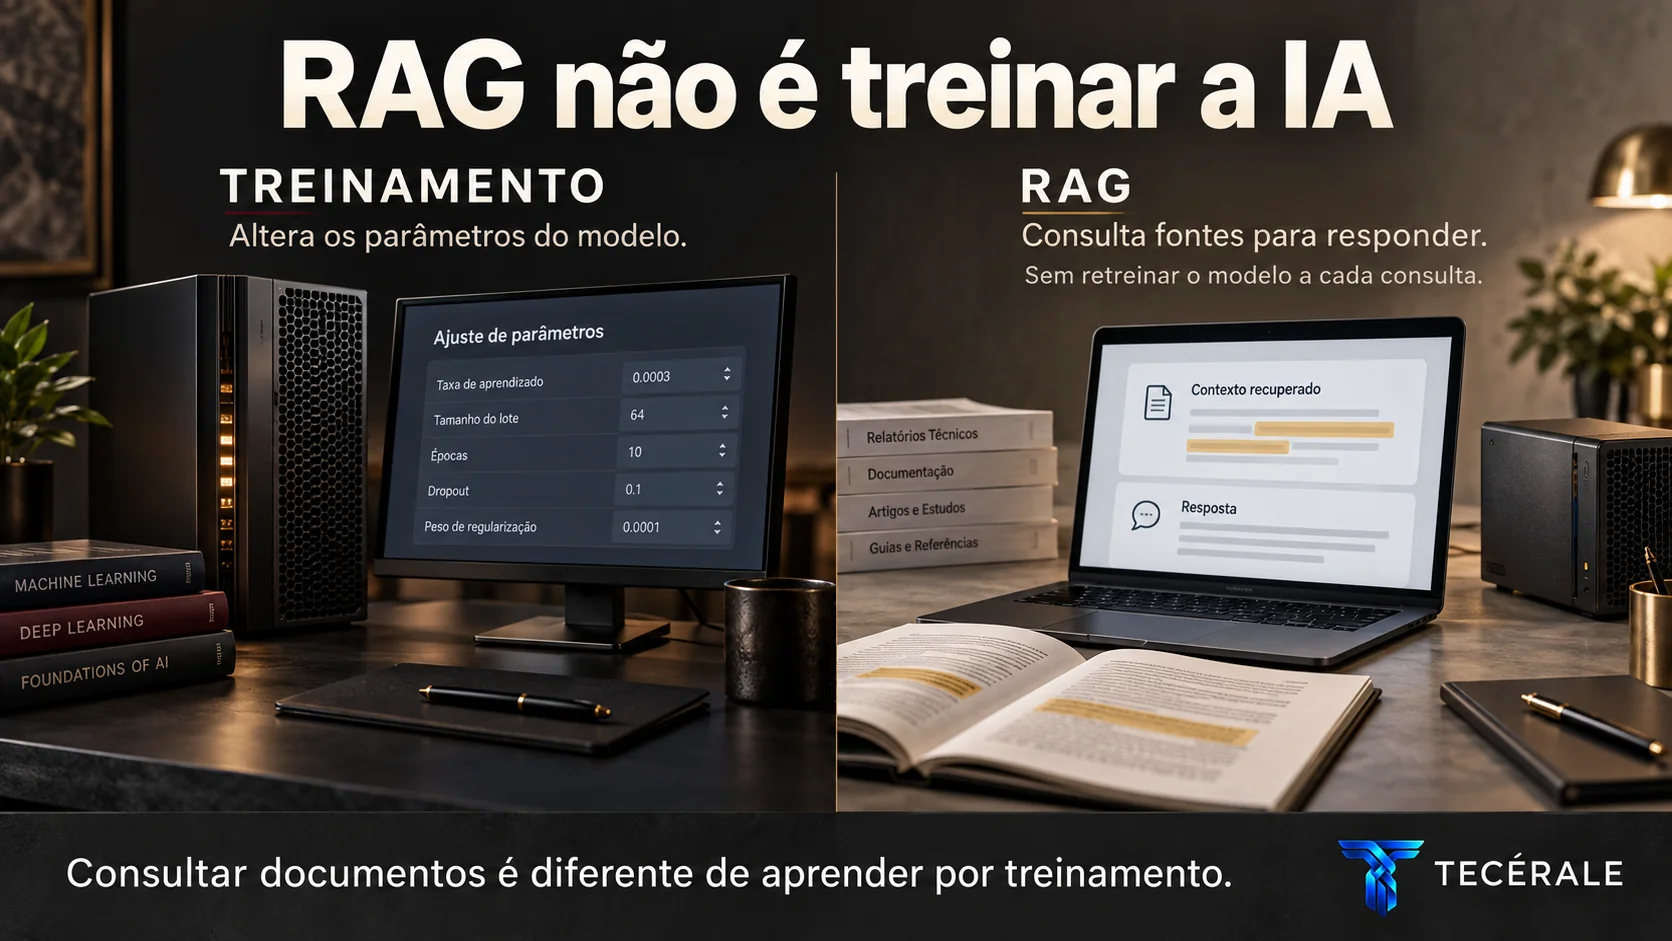
Adicionar documentos a um sistema RAG normalmente não significa retreinar o modelo de linguagem.
Os documentos continuam funcionando como fontes que podem ser consultadas.
Quando surge uma pergunta, o sistema busca os trechos relevantes e coloca esse conteúdo no contexto usado para gerar a resposta.
Na documentação da OpenAI, por exemplo, arquivos adicionados a um vector store podem ser automaticamente divididos em partes, transformados em embeddings e indexados para pesquisa semântica.
Para quem não é técnico, basta guardar a diferença:
treinamento muda o modelo.
RAG dá ao modelo acesso a informações recuperadas no momento da pergunta.
Um exemplo dentro de uma empresa
Imagine uma clínica com estes documentos:
- lista de convênios;
- valores de consultas;
- horários;
- regras de retorno;
- orientações para exames;
- política de cancelamento.
Um paciente pergunta no WhatsApp:
“Se eu cancelar minha consulta hoje, pago alguma taxa?”
Sem acesso à política da clínica, um modelo pode simplesmente não saber a resposta correta.
Em um sistema com RAG, a pergunta pode acionar uma busca nos documentos. O sistema encontra a seção sobre cancelamento e entrega esse trecho ao modelo.
A IA então monta a resposta com base naquela informação.
O mesmo princípio pode ser usado em:
- manuais internos;
- catálogo de produtos;
- políticas comerciais;
- documentação técnica;
- procedimentos;
- perguntas frequentes;
- contratos ou regulamentos, quando o caso de uso e os controles forem adequados.
Isso também ajuda a entender como um agente de IA pode responder perguntas específicas da empresa sem depender apenas do conhecimento geral do modelo.
Por que os documentos precisam ser preparados
Aqui aparece uma parte menos glamourosa, mas muito importante.
RAG não transforma documentos ruins em uma boa base de conhecimento.
Se a empresa possui três arquivos diferentes com três preços diferentes para o mesmo serviço, a IA continua diante de três informações conflitantes.
Também pode haver PDFs enormes, tabelas difíceis de interpretar, documentos duplicados, versões antigas e informações sem contexto.
Em muitas implementações, documentos grandes são divididos em partes menores para que o sistema consiga recuperar apenas os trechos mais relacionados à pergunta. Sistemas atuais também podem usar busca por palavra-chave, busca semântica, vetores ou combinações dessas técnicas.
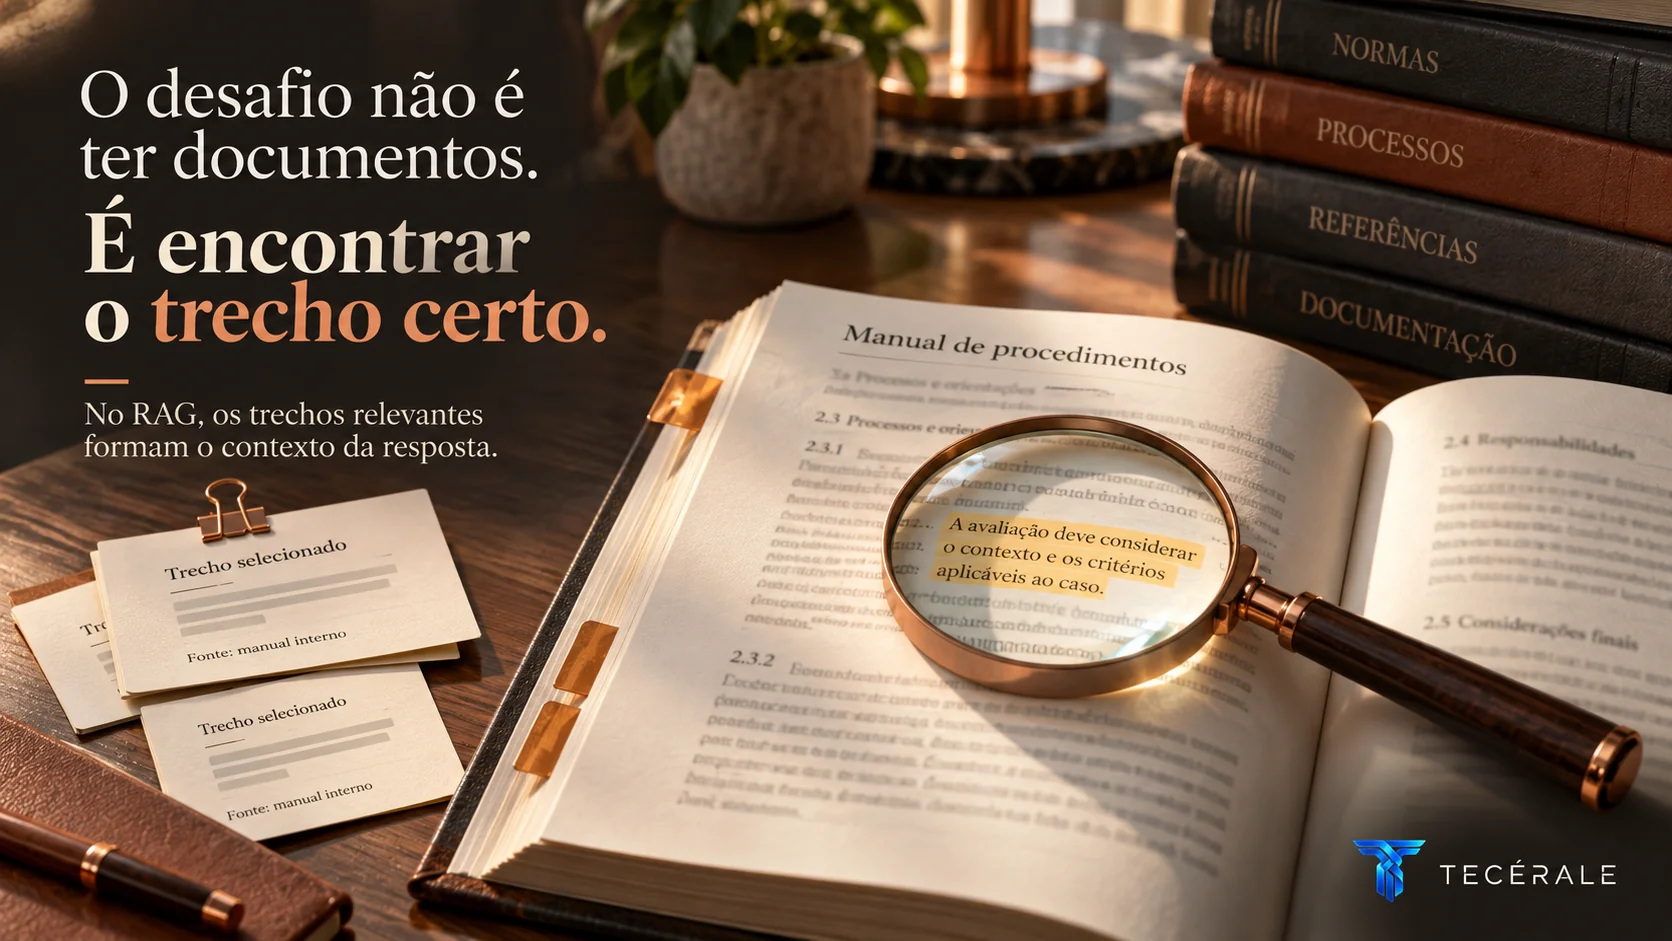
O detalhe técnico varia.
O princípio não:
para encontrar uma boa resposta, primeiro é preciso conseguir encontrar uma boa fonte.
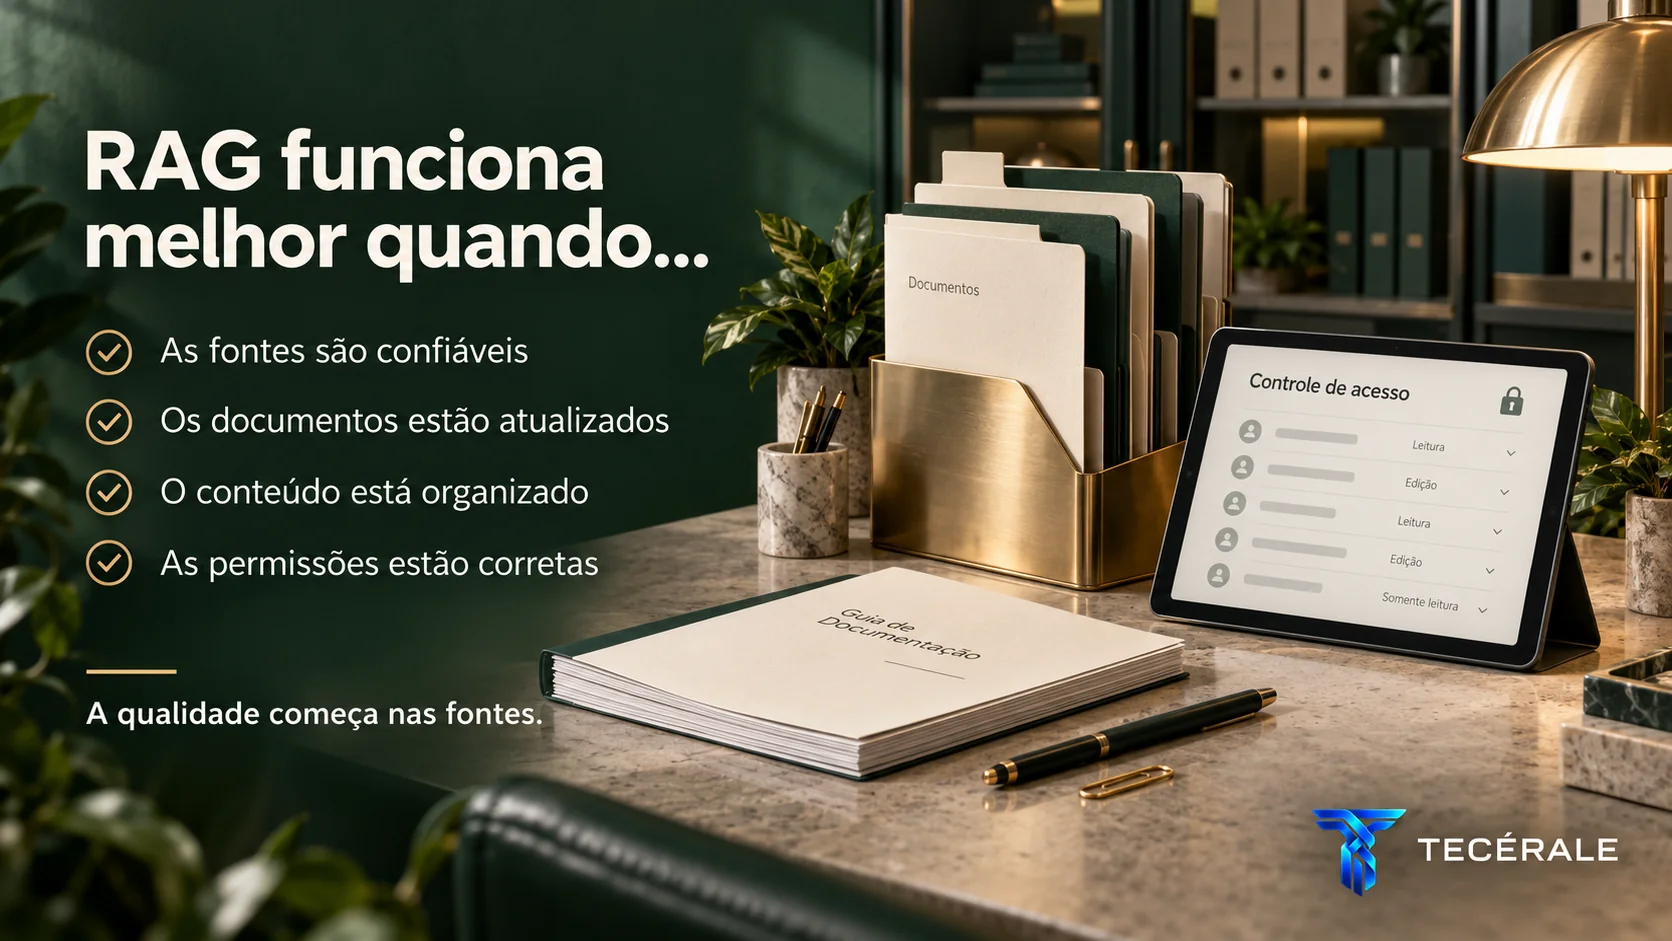
Por isso, antes de colocar IA em cima de uma pasta cheia de arquivos, vale organizar:
- qual documento é oficial;
- quem atualiza cada informação;
- quais versões ainda valem;
- quem pode acessar o quê;
- quais conteúdos devem ser excluídos ou revisados.
RAG reduz erros, mas não elimina erros
RAG ajuda a fundamentar a resposta em fontes reais e pode reduzir a necessidade de o modelo preencher lacunas sozinho.
Mas isso não significa perfeição.
O sistema pode:
- recuperar o trecho errado;
- não encontrar uma informação importante;
- interpretar mal uma fonte;
- usar um documento desatualizado;
- produzir uma conclusão que vai além do texto recuperado.
Em assuntos críticos, a solução precisa considerar validação, citações, registro de fontes e supervisão humana.
Outro ponto essencial é segurança.
Se os documentos são privados, o usuário só deveria conseguir recuperar aquilo que está autorizado a acessar. A documentação empresarial de RAG trata segurança e governança como partes centrais da solução, não como detalhe posterior.
Onde a TECÉRALE entra nisso?
A TECÉRALE pode conectar agentes e sistemas de IA às informações da própria empresa quando isso realmente melhora o processo.
O trabalho não começa simplesmente “jogando PDFs na IA”. É preciso definir as fontes confiáveis, organizar o conhecimento, controlar acessos e decidir o que o agente pode fazer com a informação encontrada.
Esse cuidado separa uma demonstração interessante de uma solução que pode ser usada no dia a dia.
Quando RAG faz sentido
RAG costuma fazer sentido quando a resposta depende de informações que:
- pertencem à própria empresa;
- mudam ao longo do tempo;
- estão distribuídas em muitos documentos;
- são específicas demais para depender do conhecimento geral de um modelo;
- precisam ser recuperadas conforme a pergunta.
Por outro lado, nem toda aplicação precisa de RAG.
Se existem apenas dez respostas fixas e bem definidas, uma estrutura simples pode resolver melhor. Esse é o mesmo princípio discutido em Onde NÃO usar IA dentro de uma empresa: adicionar tecnologia só faz sentido quando ela reduz um problema real.
O ponto principal
RAG parece técnico porque envolve conceitos como recuperação, índices, embeddings e busca semântica.
Mas a ideia essencial é muito simples:
antes de responder, a IA consulta uma fonte relevante.
É isso que permite criar experiências em que um modelo trabalha com informações específicas de uma empresa sem depender apenas do que aprendeu durante seu treinamento.
E a qualidade dessa experiência não depende só do modelo.
Depende também de:
- bons documentos;
- informações atualizadas;
- uma boa busca;
- permissões corretas;
- regras claras sobre como usar o conteúdo recuperado.
Se sua empresa possui conhecimento espalhado em documentos e quer avaliar se vale conectá-lo a um agente ou sistema de IA, a TECÉRALE pode ajudar a desenhar uma solução adequada ao processo.
Fontes e referências
Microsoft Learn — RAG e IA generativa no Azure AI Search: https://learn.microsoft.com/pt-br/azure/search/retrieval-augmented-generation-overview
OpenAI Developers — Retrieval: https://developers.openai.com/api/docs/guides/retrieval
OpenAI Developers — File search: https://developers.openai.com/api/docs/guides/tools-file-search
Google Cloud — Vertex AI APIs for search and RAG: https://docs.cloud.google.com/generative-ai-app-builder/docs/builder-apis
Conteúdo para entender a tecnologia antes de decidir como aplicá-la.

Comentários
Converse sobre o artigo, complemente a discussão ou tire dúvidas.
Entre na sua conta para comentar e responder.
Carregando comentários…